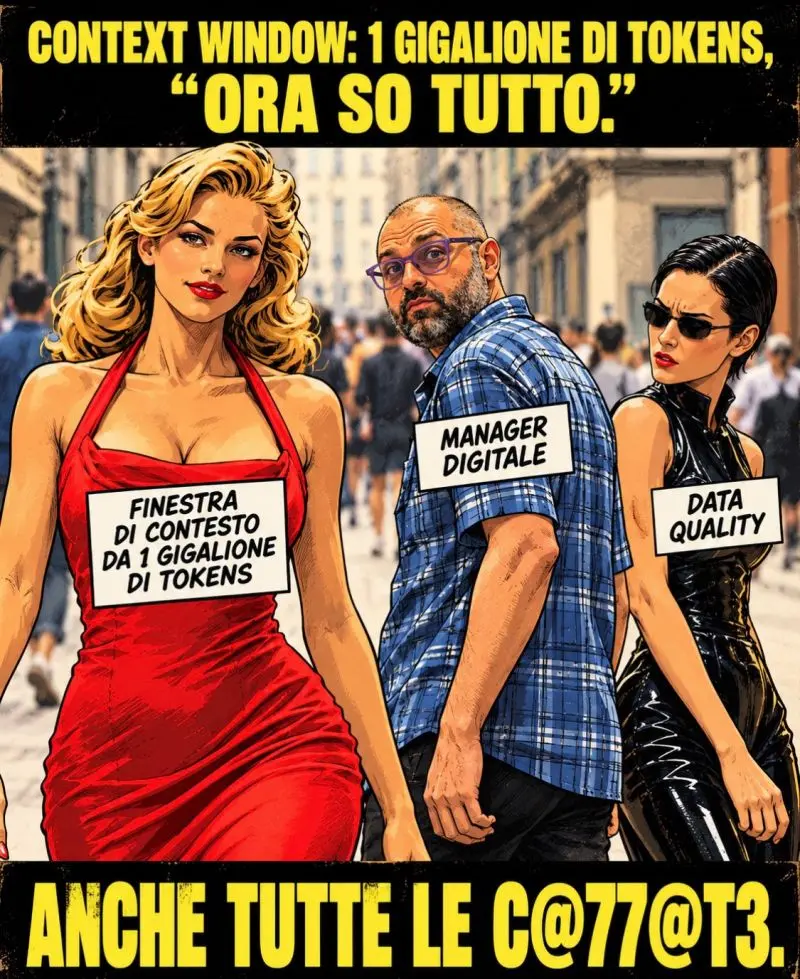
Cari colleghi, vi state rendendo conto che state dando in pasto ai vostri agenti AI tutto il vostro SharePoint e ogni cartella condivisa dal 2017, convinti di avergli dato la conoscenza dell’azienda? E se questa fosse una c@zz@t@ nucleare, ve lo siete chiesto?
Eh sì, perché siccome i vostri dati non sono strutturati gli avete dato accesso a vent’anni di disorganizzazione, nella speranza che metta ordine nel vostro caos.
È un tema di finestra di contesto, signori: per anni abbiamo chiesto finestre sempre più grandi, convinti che più roba infiliamo nella testa del modello, più diventa intelligente. Una specie di dirigente onnisciente che ha letto tutte le mail, tutti i verbali e le millemila versioni del PowerPoint sulla trasformazione digitale.
Peccato che avere tutte le informazioni non voglia dire decidere meglio. Vi faccio un esempio: nel luglio 2025 uno studio di Chroma ha testato 18 modelli, compresi quelli di punta. Si sono accorti che, controintuitivamente, le prestazioni peggioravano man mano che l’input si allungava, anche su compiti banali.
Come è possibile?
Immaginate di chiudere un neoassunto dirigente, al primo giorno di lavoro, in una stanza con dieci anni di email, procedure (superate) e verbali (smentiti tre settimane dopo), tonnellate di messaggi e un archivio documentale non aggiornato. E poi gli chiedete di decidere su qualcosa: onestamente, vi stupite se sbaglia?
Con gli LLM facciamo la stessa cosa, solo che la chiamiamo Context Engineering e ci sentiamo molto innovativi.
Il fatto è che un’informazione sbagliata contamina le risposte successive, un documento irrilevante distrae, due procedure contraddittorie costringono il modello a scegliere, e indovinate quale sceglie.
Il modello qui c’entra poco. In azienda confondiamo da sempre la disponibilità delle informazioni con la loro utilità, e l’AI ce lo restituisce moltiplicato.
Un buon sistema AI deve sapere quali informazioni servono, quali sono attendibili, quali aggiornate e soprattutto quali ignorare.
Come sempre, una buona governance è molto meno fotogenica presso il board della scelta dell’ultimo modello, quindi perché preoccuparsi?
Ce li avete anche voi dei soggetti in azienda che danno in pasto archivi fuffa agli LLM senza vergognarsi? Volete raccontare qualche “storia dell’orrore”?