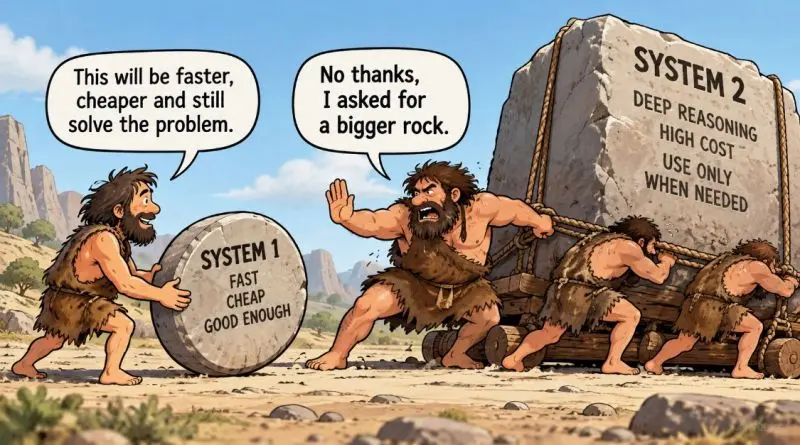
L’altra sera ho letto un paper che lega il lavoro di Kahneman (Thinking Fast and Slow) al mondo dell’AI e mi sono accorto che una parte di quello studio la stavo già applicando ogni giorno, senza averle mai dato un nome.
Il paper parte da Kahneman: un System 1 veloce, intuitivo ed economico e un System 2 lento, analitico e potenzialmente molto costoso.
È interessante notare come in genere possiamo decidere il livello di ragionamento di un agente prima di lanciarlo, ma questo si presta poco a task a lungo orizzonte.
Più effettivo, invece, è aggiungere un livello metacognitivo che decida di volta in volta quale dei due sistemi attivare guardando la difficoltà del problema in modo oggettivo, eventuali risorse in token disponibili e loro limiti, esperienza passata e valore di una risposta corretta va costo di quella errata.
D’altronde, saper ragionare serve a poco all’agente se non sa quando vale la pena ragionare di più.
Laddove con ChatGPT in modalità chat possiamo fare questo switch d’istinto — e in realtà la macchina lo fa già da sola ma senza chiederti su quali parametri switchare.
Quello che vogliamo invece ottenere è un agente che partendo dalla modalità standard e analizzando la situazione su parametri che gli dai tu, se serve aggiunga profondità, alzi il reasoning, e si regoli in modo automatico, ma con le regole che gli imponi tu.
Basta creare un agente metacognitivo che, ad un primo livello, affronta il task con un modello veloce ed economico e, prima di rispondere, valuta complessità, ambiguità, informazioni mancanti, costo dell’errore e verificabilità in base a parametri che gli hai dato.
Oltre una certa soglia scatta la task delegation a subagent assegnati con modelli diversi e più adeguati.
In questo modo, anche su task di lungo orizzonte, si evita di stare pagando il premium in token quando non è necessario.
Il principale errore da evitare
Un errore ingenuo che vi consiglio di evitare è quello di chiedere all’AI quanto è sicura da 0 a 100: la confidence dichiarata da un LLM è testo generato come tutto il resto, quindi senza alcuna garanzia di essere una probabilità calibrata. In poche parole: inaffidabile.
Conviene invece chiedere alla macchina segnali misurabili ed oggettivi: ad esempio quante assunzioni il modello è stato costretto a fare, oppure se il risultato si può verificare, o anche quanto costerebbe l’errore se il modello sbagliasse. E su questi costruire la task delegation.
Il prossimo salto negli LLM
Sono sempre più convinto che il prossimo salto nell’uso degli LLM riguarderà probabilmente meno la quantità di pensiero e più la capacità dei sistemi di decidere quando pensare in modo totalmente autonomi, ma sempre con parametri configurabili da chi esegue la macchina.
Vi chiedo quindi: nei vostri progetti AI chi decide quale modello lavora su quale task? Un criterio? Un’abitudine? Avete già testato questo principio e volete condividerne gli esiti?